Aperçu des sections
-
Durée d'apprentissage du module : 4 Semaines
-
-
Consulter Recevoir une note
-
Durée d'apprentissage de la leçon : 01 semaine
Objectifs de la leçon
1 Définir le Machine Learning et la différence avec la programmation traditionnelle ;
2 Identifier les différents types d'apprentissage (supervisé, non supervisé, par renforcement) ;
3 Décrire les principales étapes d'un workflow Machine Learning ;
4 Comprendre le rôle des données, des caractéristiques (features) et des modèles ;
5 Reconnaître plusieurs applications concrètes du Machine Learning.
-
Bonjour à toutes et à tous,Vous trouverez ci-dessus le support au format PDF de notre cours magistral dédié aux CONCEPTS FONDAMENTAUX DE L'APPRENTISSAGE AUTOMATIQUE. Ce document constitue la base théorique essentielle pour valider ce module.Pour aborder ce chapitre efficacement, je vous invite à suivre les consignes ci-dessous :
- 📖 Lecture attentive : Prenez le temps de lire l'intégralité du document avant notre prochaine séance.
- ✍️ Prise de notes : Ne vous contentez pas de lire. Notez les définitions clés et les concepts qui vous semblent complexes.
- ❓ Forum de discussion : Si un point reste obscur, posez vos questions dans le le Forum avant le Date prochaine du cours suivant . Nous y répondrons ensemble.
- 🚀 Prochaine étape : Cette lecture est obligatoire pour pouvoir réaliser le quiz d'auto-évaluation en ligne disponible la semaine prochaine.
Bon travail à vous !
-
-
Consulter Écrire des messages de forum : 1
-
Durée d'apprentissage de la leçon : 01 semaine
Objectifs de la leçon
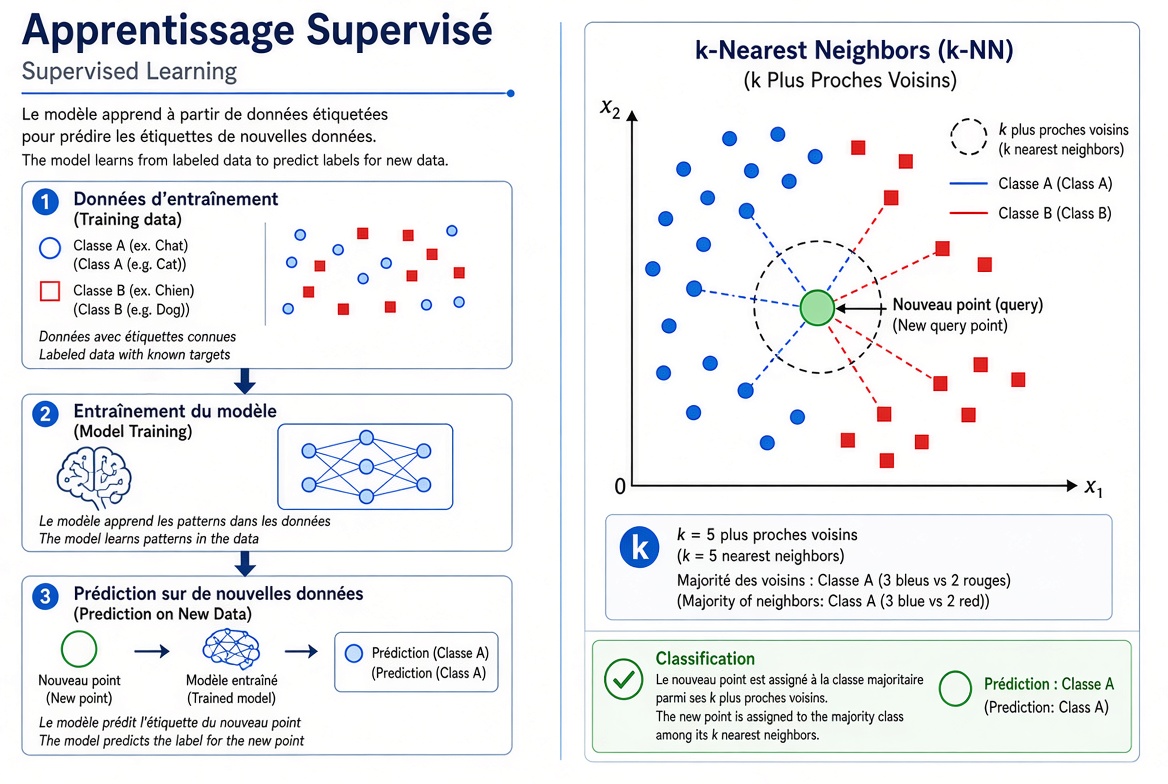
- 1 Expliquer le principe du k-nearest neighbors (k-NN) ;
- 2 Implémenter l'algorithme k-NN en Python avec scikit-learn ;
- 3 Choisir une métrique de distance adaptée au problème ;
- 4 Évaluer les performances d'un classifieur k-NN ;
- 5 Distinguer les problèmes de classification et de régression supervisée.
-
4.6 Mo Document Word 2007 Déposé le 24 août 26, 11:55Consulter
-
Consulter Écrire des messages de forum : 1
-
Consulter
-
-
Durée d'apprentissage de la leçon : 01 semaine
Objectifs de la leçon
- 1 Expliquer les notions de biais, variance et compromis biais-variance ;
- 2 Mettre en œuvre la validation croisée (cross-validation) ;
- 3 Utiliser des métriques d'évaluation adaptées (accuracy, F1, AUC-ROC) ;
- 4 Identifier et prévenir le surapprentissage (overfitting) ;
- 5 Comparer et sélectionner le meilleur modèle pour un problème donné.
-
241.8 Ko Document Word 2007 Déposé le 24 août 26, 09:38Consulter
-
Consulter Écrire des messages de forum : 1
-
Objectifs du TP
À la fin de cette séance, vous serez capables de :
- Séparer correctement un jeu de données en train / validation / test
- Utiliser la validation croisée (k-fold)
- Optimiser des hyperparamètres avec GridSearchCV et RandomizedSearchCV
- Comparer plusieurs modèles de façon rigoureuse
- Choisir et interpréter les métriques adaptées (classification et régression)
- Éviter le data leakage
-
-
Durée d'apprentissage de la leçon : 01 semaine
Objectifs de la leçon
- 1 Distinguer le principe de la régression linéaire et logistique ;
- 2 Implémenter un modèle de régression en Python ;
- 3 Évaluer les performances d'un modèle de régression ;
- 4 Identifier les situations de surapprentissage ;
- 5 Comprendre la descente de gradient et l'optimisation des paramètres.
-
241.5 Ko Document Word 2007 Déposé le 24 août 26, 11:02Consulter
-
Consulter Écrire des messages de forum : 1
-
Durée d'apprentissage de la leçon : 01 semaine
Objectifs de la leçon
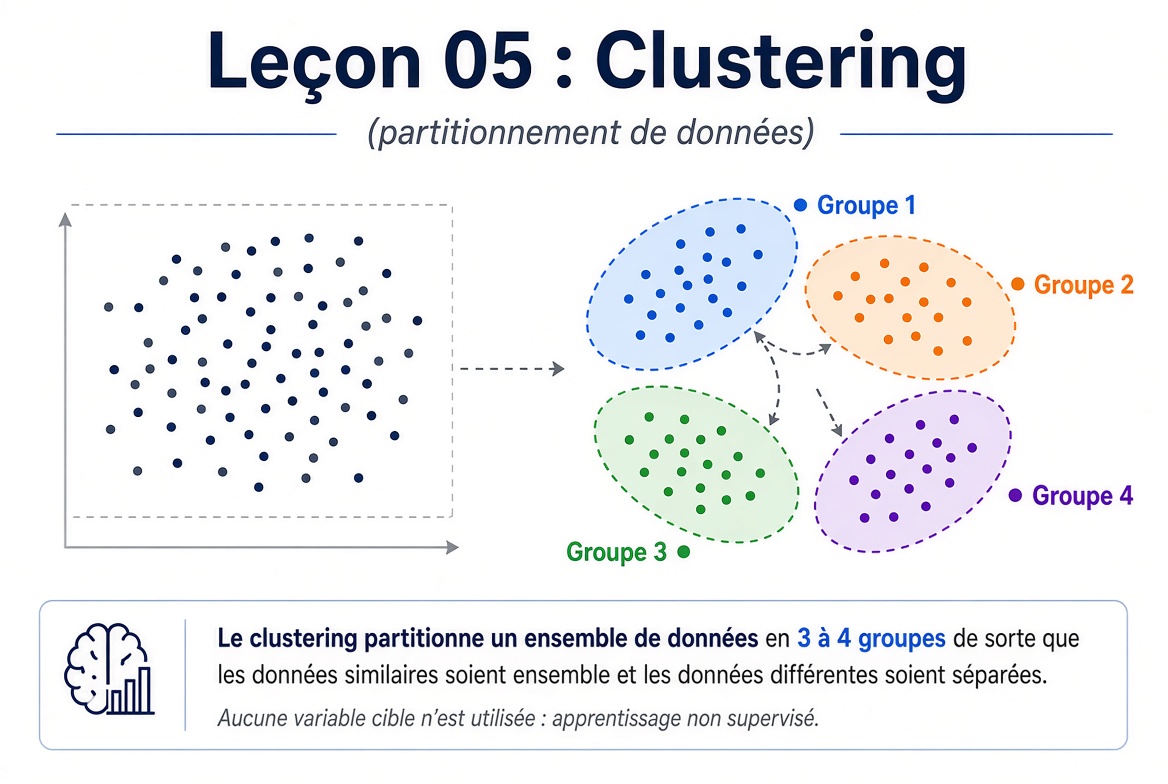
- 1 Distinguer le principe du clustering non supervisé ;
- 2 Utiliser l'algorithme K-means ;
- 3 Déterminer le nombre optimal de clusters (méthode du coude, silhouette) ;
- 4 Interpréter les groupes obtenus et évaluer leur cohérence ;
- 5 Appliquer des techniques de visualisation pour explorer les clusters.
-
514.4 Ko Document Word 2007 Déposé le 24 août 26, 11:43Consulter
-
Consulter Écrire des messages de forum : 1
-
Durée d'apprentissage de la leçon : 01 semaine
Objectifs de la leçon
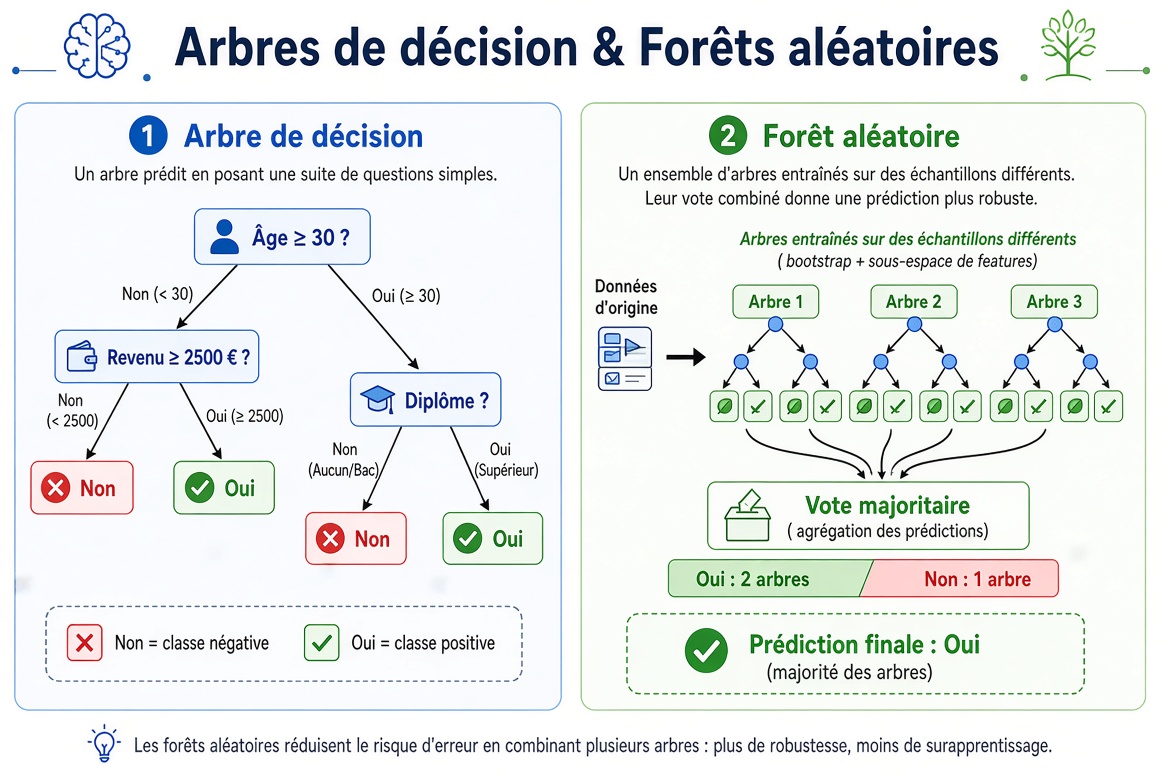
- 1 Expliquer le fonctionnement d'un arbre de décision (CART) ;
- 2 Construire et visualiser un arbre de décision en Python ;
- 3 Appliquer les forêts aléatoires (Random Forests) et le bagging ;
- 4 Interpréter l'importance des variables dans une forêt aléatoire ;
- 5 Comparer les performances arbres individuels vs modèles ensemblistes.
-
Consulter Écrire des messages de forum : 1
-
Objectif alpha =====>
Note à l'attention de l'équipe projet — ce document est un premier jet complet, structuré selon le canevas exigé au §6.1 de l'appel. Les passages entre crochets en rouge doivent être complétés ou vérifiés avant soumission ; les montants, dates et effectifs indiqués sont indicatifs et doivent être ajustés à la composition réelle du consortium et aux coûts effectifs.
-
Consulter
-
Consulter
-
Consulter
-
Consulter Remettre un travail
-
Consulter Envoyer des tentatives : 2
-
Consulter Recevoir une note
-
-
Examen : Session 1 - Session 2
 Évaluation finale
Réalisez les tests et exercices finaux pour valider vos connaissances et mesurer votre progression dans cette leçon.
Méthode de calcul de la moyenne :- Session 1 : 40% Évaluation devoir + 60% Examen
- Session 2 : 40% Évaluation devoir + 60% Examen
-
